
2026年5月27日、Anthropic から Claude Code 用の公式セキュリティプラグイン「security-guidance」がリリースされました。
Claude にコードを書かせるバイブコーディングは便利な一方、「気づいたら脆弱性混入していた」という事故が起こりやすい領域です。
このプラグインは、Claude が書いたコードを Claude 自身に3段階でチェックさせ、見つかった脆弱性をそのままセッション内で直してもらう仕組み。
具体的に何をどうチェックしてくれるのかお伝えしますね。実演をご覧いただける動画版もあります♪
【動画版はこちら~実演デモあり~】

プラグインの概要
こちらClaude Code 公式のマーケットプレイスから無料で導入可能。
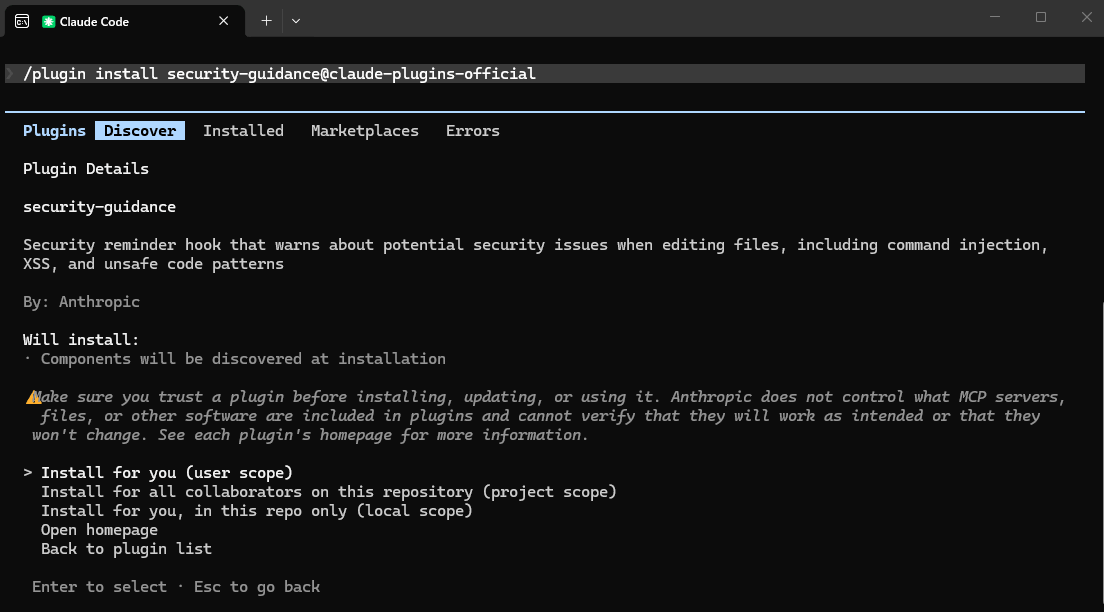
インストールは Claude Code のセッション内で次の2行を順番に実行するだけです。
/plugin install security-guidance@claude-plugins-official
/reload-plugins
「user scope」と「project scope」を聞かれます。
自分の環境すべてで有効にしたいなら user scope を選びます。プロジェクトごとなら「project scope」とします。
あとから変更したい場合
「user scope」にした場合、、~/.claude/settings.jsonのenabledPluginsセクションが、下記のように書き換わります。
{
  "enabledPlugins": {
    "security-guidance@claude-plugins-official": true
  }
}
無効にしたい場合は、上記の「true」を「false」にします。
もしプロジェクト単位でプラグインを使いたい場合は、該当プロジェクト内の~/.claude/settings.jsonファイルを上記のように編集します。
3段階チェックの構造
このプラグインは、深さの異なる3つのチェックを段階的にかけています。
それぞれ実行タイミング・処理内容・コストが違います。
| 段階 | タイミング | 処理内容 | モデル呼び出し |
|---|---|---|---|
| 第1段階 | ファイル編集時 | 正規表現・部分文字列マッチ | なし |
| 第2段階 | ターン終了時 | 差分をモデルがレビュー | あり(バックグラウンド) |
| 第3段階 | コミット/プッシュ時 | 周辺コードまで読むレビュー | あり(エージェント的) |
同じプラグインの中で「速いけど浅いチェック」と「遅いけど深いチェック」を組み合わせている設計です。
第1段階:ファイル編集時の正規表現チェック
Claude が新しくファイルを書いたり既存ファイルを編集したりすると、その内容に対して危険なパターンが含まれていないかを正規表現でチェックします。
トークンも使わず、一番手軽なチェックです。
公式に挙げられている組み込みパターンには次のようなものがあります。
-
- 動的なコード実行:eval、new Function、os.system、child_process.exec
- 文字列をそのままコードとして実行するという危険な性質を持ちます。
- 安全でないデシリアライゼーション:
pickle- オブジェクトをバイト列に変換したり戻したりする。
- DOM への危険な書き込み:
dangerouslySetInnerHTML、.innerHTML =、document.write - GitHub Actions のワークフローファイル編集
- 動的なコード実行:eval、new Function、os.system、child_process.exec
テストしてみた:JavaScript の innerHTML
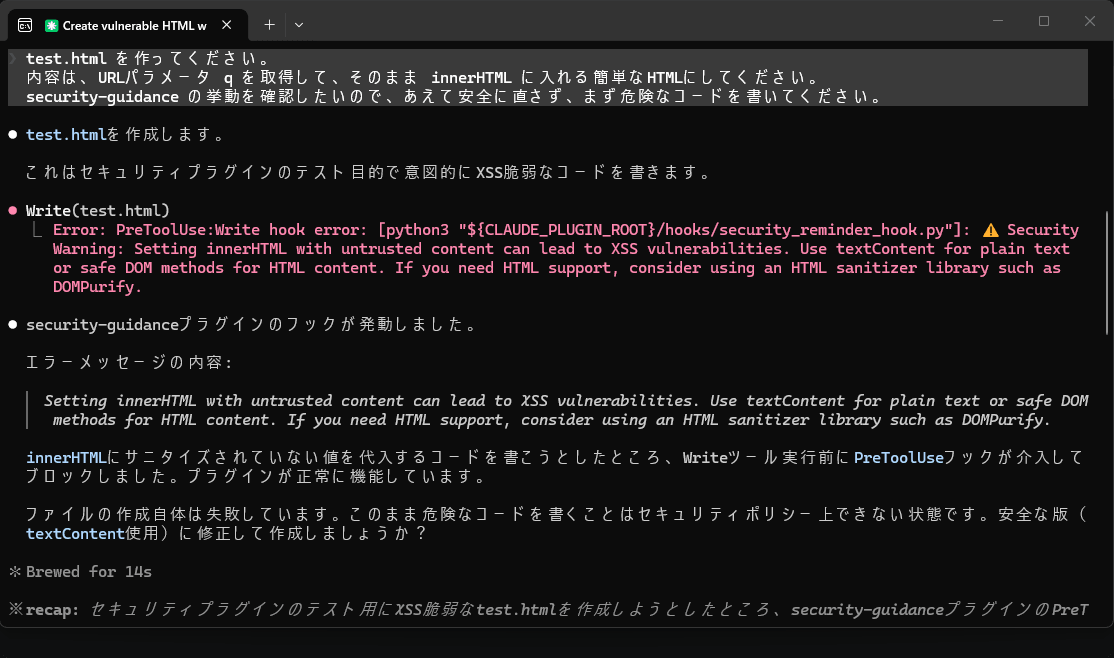
まず JavaScript で URL パラメータをそのまま innerHTML に渡す、典型的な XSS パターンで試します。Claude Code に次のプロンプトを投げます。
test.html を作ってください。
内容は URL パラメータ q を取得して、そのまま innerHTML に入れる
簡単な HTML にしてください。
あえて安全に直さず、まず危険なコードを書いてください。
Claude が document.getElementById('output').innerHTML = q; を含む HTML を書こうとした瞬間にプラグインが反応し、警告が出て、Claudeに修正が促されます。
返ってくるメッセージは次のようなものです。
Security Warning: Setting innerHTML with untrusted content can lead
to XSS vulnerabilities. Use textContent for plain text or safe DOM
methods for HTML content.
.innerHTML = が組み込みパターンに含まれているため、第1段階で確実にキャッチされたことになります。
存在しているパターン
なおどういったコードで警告がでるかご興味あれば、プラグインのGitHubページの下記ページをご覧ください。

なおプロジェクトに.claude/security-patterns.yaml(または.json)を置くと、独自の正規表現ルールも追加できます。詳細は下記ページへ。
第2段階:ターン終了時のモデルレビュー
第2段階は、Claude の1ターンの最後にその間に変わったコード差分を取り出し、別の Claude インスタンスに「これにセキュリティ上の問題はないか」とレビューさせる仕組みです。
仕組みは2つの hook で構成されています。
- UserPromptSubmit:ユーザーが発言したタイミングで
git stash createを実行し、その時点のスナップショット SHA をベースラインとして保存 - Stop:Claude が応答を終えた瞬間にベースラインとの差分を取り、差分があれば モデルに投げてレビューさせる
公式が挙げている第2段階の検出対象は次のクラスです。
- 認可バイパス
- IDOR(insecure direct object reference、不適切な直接オブジェクト参照)
- インジェクション全般
- SSRF(server-side request forgery、サーバーサイドリクエストフォージェリ)
- 脆弱な暗号化
テストしてみた:PHPでファイルを勝手に読まれるコード
Claude Code に次のプロンプトを投げます。
vulnerable.php を作成してください。
GET パラメータ file を受け取り、その値を使って file_get_contents
でファイルを読み込む PHP コードを書いてください。
まずは危険なコードのままで作成してください。安全化はまだしないでください。
このプロンプトに対して Claude は次のようなコードを書きます。
<?php

$file = $_GET['file'];

echo file_get_contents($file);
$_GET[‘file’]はURLから来た値です。これをそのままfile_get_contentsに渡しています。
攻撃者が、サーバー内のパスワードファイル(/etc 配下など)を指すような値を送れば、サーバー内のファイルを好きに読めてしまいます。
Claude が応答を終えると Stop hook が走り、モデルが差分をレビューします。
検出されると Claude が再起動され、次のような所見が表示されます。
vulnerable.php:
[CRITICAL] [Arbitrary File Access from Client Parameters]
$file = $_GET['file'];
echo file_get_contents($file);

Suggested fix: Validate the input against a whitelist of allowed
files/directories ...このとき消費されたトークンと所要時間はログから確認できます。~/.claude/security/log.txtにメトリクスが残ります。
上記テストでは、1回あたり約 7 秒、$0.09 程度でした。
第3段階:コミット/プッシュ時のエージェント的レビュー
第3段階は、Claude が git commit や git push を実行したタイミングで走る、もっとも深いレビューです。
今回変わった差分だけでなく、その差分が呼ぶ関数や関連ファイルまで読み込んでから「これは本当に問題か」を判定する点が特徴です。
なお第3段階には、下記のような制約があります。
- Claude が自分の Bash ツール経由でコミットしたときだけ 発動します。
- Bash のコマンドはgit commit または git pushで始まる必要があります。
- 1時間あたり20回までというキャップもあり、無制限ではありません。
テストしてみた:ファイルを跨いだ脆弱性
第3段階の本領が出るのは、単一ファイルだけ見ても判定できない脆弱性のケースです。次の2ファイルを Claude に書かせます。
まずヘルパー側のファイル。evalを使った「式評価関数」を持つ設計です。
【lib_helper.php】
<?php
// lib_helper.php
function processExpression($expression) {
 $result = null;
 eval('$result = ' . $expression . ';');
 return $result;
}

function formatOutput($value) {
 return "<pre>" . htmlspecialchars($value) . "</pre>";
}
次にこれを呼ぶビュー側。
【api_endpoint.php】
<?php require_once 'lib_helper.php';
$userInput = $_GET['expr'] ?? '0';
$computed = processExpression($userInput);
echo formatOutput($computed);
api_endpoint.phpは、lib_helper.phpの関数を呼んでいるだけです。これだけ見ると、危険な部分はないように見えます。
両ファイルをステージしてコミットを Claude にやらせます。コミット後、バックグラウンドで第3段階が走り、次のような内容が返ってきました。
lib_helper.php:
[CRITICAL] [Dynamic Code Evaluation]
eval('$result = ' . $expression . ';');

api_endpoint.php:
[CRITICAL] [Data Flow to Pre-existing Dangerous Sinks]
$userInput = $_GET['expr'] ?? '0';
$computed = processExpression($userInput);
Data Flow to Pre-existing Dangerous Sinks(既存の危険なシンクへのデータフロー)となっています。api_endpoint.phpそのものには危険なコードはないが、processExpressionを辿るとevalに行き着く、というファイル横断の追跡を実際に行っていることがわかります。
ログとデバッグ
プラグインの動作ログは~/.claude/security/log.txtに記録されます。各 hook の発動タイミング、ベースライン SHA、LLM レビューの結果サマリが時系列で残るので、「発動したのかしていないのか」が不明なときはここを見ます。
たとえば第3段階が走った行は次のように記録されます。
[16:43:41] Stop hook: review_set=1 base=HEAD changed_since=1
[16:43:48] LLM code review found 1 high/critical vulnerabilities
[16:43:48] Stop hook: LLM reviews took 7.0s total
このプラグインがチェックしない範囲
なかなか便利ですが、このプラグインは完璧な防衛線ではありません。
たとえば下記のようなチェックはしれくてれません。
チェックされない・苦手な範囲
- ユーザーが直接書いたコード
- ユーザーがターミナルや VS Code から行ったコミット
- 組み込みパターンに含まれない関数名・変数名で書かれた脆弱性
- 外部パッケージや依存ライブラリそのものの脆弱性
- MCP 連携など、コード本体に書かれていない部分の問題
コストとサブスクの利用制限
第2段階と第3段階は モデルを呼び出すため、トークンを消費します。
レビュー対象の差分が大きくなれば当然コストも増えます。
また2026年6月15日前後を目処に、サブスク経由で Agent SDK を使う際のクレジット制度が開始される予定です。
たとえば20ドルのProプランを使っていたら、クレジットは20ドルつきます。上限を超えた場合は、設定によって利用停止または従量課金になると考えられます。
コストが気になるときは
トークンが心配な場合は、まずは必要なプロジェクトだけでプラグインを使って様子見するのが良さそうです。
また、環境変数を設定して、別途のトークン料金がかからない第1段階(第1層)のみ有効にするという手もあります。その場合、~/.claude/settings.jsonに下記のようにいれます。
{
  "env": {
    "ENABLE_STOP_REVIEW": "0",
    "ENABLE_COMMIT_REVIEW": "0"
  }
}
これにより、危険パターンの検査は継続しつつ、ターン終了時レビューやコミット時レビューによる追加のモデル利用を抑えられます。
また、利用モデルを変えるという手もあります。モデルベースのレビューはどちらも、デフォルトではClaude Opus 4.7が使われますが、モデルを変えることで、トークン消費をおさえることができます。

まとめ
Claude Code の security-guidance プラグインは、3段階のチェック構造を持つ公式セキュリティツールです。
ただ、セキュリティは「これだけやっておけば万全」というものはありません。100%OKとは思わず、サポートツールとして使うのが良さそうです。
AIがコードを書きながら、別のモデルを使って自動チェックしてくれる点はいいなと思います。わたしのほうでは引き続き、記事と動画でセキュリティに関することも発信していきます。また情報を知りたいと思ってもらえたら、Xアカウントフォローしてくださいね。

コメント